Turkish writing
Evde Tekerlek Yaparken Sokaktan Spor Arabalar Geçti: Taksim’in Hikâyesi
Bir maliyet optimizasyonu fikrinin, geliştirici araçları için bir Intelligence Control Plane’e dönüşme süreci.
Also available in English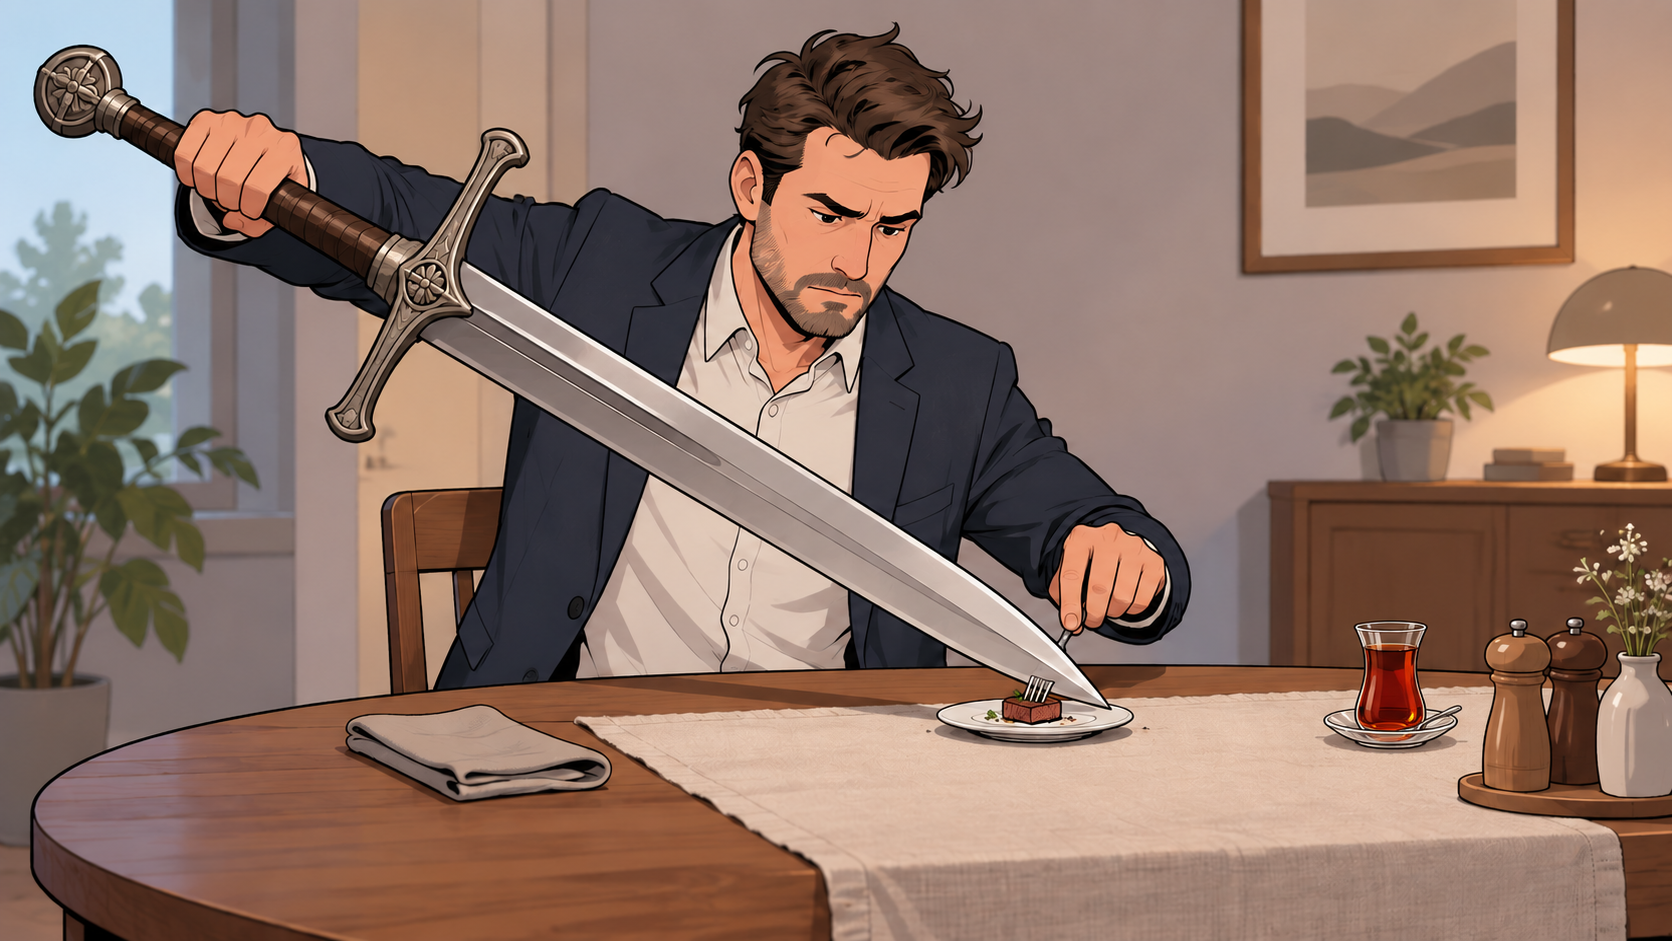
Her iş için frontier model kullanmak bazen tam olarak böyle hissettiriyor.
Yapay zekâ destekli yazılım geliştirmede çoğu zaman tuhaf bir varsayımla hareket ediyoruz: En iyi sonucu istiyorsak her işi elimizdeki en güçlü modele vermeliyiz.
İlk bakışta mantıklı görünüyor. Kod tabanını anlamasını, doğru mimari kararlar vermesini, testleri çalıştırmasını ve saatler sürebilecek bir işi otonom biçimde tamamlamasını beklediğimiz bir agent’a neden daha zayıf bir model verelim? Üstelik neredeyse her hafta daha gelişmiş bir model yayımlanıyor; doğal olarak en güncel ve en güçlü modeli kullanma isteğimiz de artıyor.
Sorun şu ki bütün işler aynı seviyede zekâ gerektirmiyor.
Bir dosyanın adını değiştirmek, bilinen bir pattern’i uygulamak, birkaç benzer test üretmek veya açıkça tarif edilmiş küçük bir düzeltmeyi yapmak ile belirsiz bir üretim hatasının kök nedenini bulmak aynı iş değil. Buna rağmen Claude Code, Codex, Devin ve Copilot gibi araçlarla çalışırken çoğumuz güvenli tarafta kalıp güçlü modeli baştan sona kullanıyoruz.
Bu tercih kaliteyi koruyor olabilir. Ama maliyet tarafında sürdürülebilir değil. En azından AI faturasını kendi cebinden ödeyenler için.
Taksim tam olarak bu gerilimden doğdu.
Önce yerel modelleri denedim
Başlangıçtaki sorum çok daha basitti:
Bulut modellerine ödediğim parayı, kaliteden vazgeçmeden azaltabilir miyim?
Güçlü sayılabilecek bir Windows makinede farklı yerel modelleri ve Ollama tabanlı akışları denedim. Teoride tablo oldukça çekiciydi. Tekrarlayan ve görece kolay işleri yerel bir model üstlenebilir, pahalı frontier modeller yalnızca gerçekten zor görevlerde devreye girebilirdi.
Deneyince işin kâğıt üzerindeki kadar kolay olmadığını gördüm. Bazı modeller günlük geliştirme akışında fazla yavaş kalıyor, bazılarıysa basit görünen bir işi tamamlıyor ama arkasında daha pahalı bir düzeltme bırakıyordu. Küçük bir modelin ucuz tamamladığı işi daha güçlü bir modele yeniden yaptırmak gerekiyorsa aslında tasarruf etmiyorsunuz; yalnızca fazladan zaman ve token harcıyorsunuz.
Bu deneyim bana yerel modellerin işe yaramadığını göstermedi. Asıl öğrendiğim şuydu: “Local-first” tek başına bir strateji değildi. Hangi işin hangi kaynağa verileceğini, sonucun yeterli olup olmadığını ve ne zaman daha güçlü bir kaynağa geçileceğini yöneten ayrı bir katmana ihtiyaç vardı.
Üstelik bu katman geliştiricinin çalışma biçimini değiştirmemeliydi. İnsanlara sevdikleri aracı bırakıp yeni bir chat ekranı kullanmalarını söylemek gerçekçi değildi. Geliştirici Claude Code kullanıyorsa Claude Code kullanmaya, Codex kullanıyorsa Codex kullanmaya devam etmeliydi.
İlk mimari fikir böyle oluştu:
- geliştiricilerin zaten kullandığı araçlar;
- ekip içinde çalışan bir veya birkaç özel model sunucusu;
- gerektiğinde erişilebilen güçlü bulut modelleri;
- bunların arasında karar veren bir intelligence gateway.
Bulut burada düşman değildi. Kalite veya kapasite gerektiğinde başvurulacak güvenli bir liman, bir escalation tier olacaktı. Bulut tarafındaki rekabet de sürekli yeni fiyat ve kapasite seçenekleri çıkarıyor. Bu rekabet Taksim’in aleyhine değil; doğru kaynağı seçebilen bir sistem için daha geniş bir kaynak havuzu anlamına geliyor.
Agent Workstation’dan Taksim’e
Bu fikir ilk başta Agent Workstation adlı masaüstü uygulamasının bir parçası olarak şekillendi. Fakat yönlendirme kararlarının bir chat ekranına veya tek bir masaüstü uygulamasına ait olmadığı kısa sürede netleşti.
Bir ekipte yapay zekâ kullanımı yalnızca bir uygulamada gerçekleşmiyor. CLI araçları, IDE eklentileri, masaüstü uygulamaları, CI süreçleri ve otonom agent’lar aynı anda devrede. Bu nedenle kontrol katmanının bunların üzerinde değil, altında yer alması gerekiyordu.
Ürünün adı da bu noktada Taksim oldu. İsim yalnızca İstanbul’daki meydanı değil; dağıtma, bölüştürme ve uygun yöne sevk etme fikrini taşıyordu.
İlk ürün tanımı kabaca bir “AI gateway” idi. Fakat proje ilerledikçe bunun da eksik kaldığını gördüm.
Ve kabul edelim: Bu, kimsenin aklına gelmeyen bir fikir değildi. Süreç devam ederken aynı probleme yaklaşan başka ürünleri de gördüm.
Bu konularda kendime sık sık hatırlattığım bir şey var: Aklındaki fikir başkası tarafından yapılmışsa hemen vazgeçme. En kötü ihtimalle, gerçek bir problemi çözen sistemin çalışan bir versiyonunu kendi ellerinle geliştirmiş ve bu süreçte ciddi bir bilgi biriktirmiş olursun. Üstelik aynı probleme farklı bir yerden bakıyor olabilirsin.
Benzer çözümleri görmek Taksim’i bırakmama değil, sınırlarını daha dikkatli düşünmeme yol açtı.
Neden yalnızca bir model router yeterli değil?
Bir router, gelen isteğe bakıp hangi modelin daha uygun olduğunu tahmin edebilir. Bu değerli bir problem ve bugün bu alanda ciddi çalışmalar var. Fakat yazılım geliştirme görevlerinde doğru seçim, isteğin başında kesin olarak bilinemiyor. Hele ki pek çok konuşma basit bir “selam” ile başladığında. :)
Bir görev kolay görünüp koddaki beklenmedik bir bağımlılık nedeniyle zorlaşabilir. Güçlü bir model ikna edici ama hatalı bir çözüm üretebilir. Daha küçük bir model ise iyi tanımlanmış bir görevde kusursuz sonuç verebilir.
Dolayısıyla asıl soru yalnızca şu değil:
Bu prompt için hangi model kullanılmalı?
Şunları da cevaplamak gerekiyor: Bu iş için hangi yetenekler gerekli? Seçilen kaynak işi gerçekten tamamladı mı? Bunu hangi kanıtla biliyoruz? Sonuç yeterli değilse ne zaman ve nereye yükseltmeliyiz? Bu sonuçtan bir sonraki karar için ne öğrenebiliriz?
Bu ayrım Taksim’i bir router fikrinden, geliştirici AI araçları için bir Intelligence Control Plane fikrine taşıdı.
Bugün projeyi en kısa şu cümleyle anlatıyorum:
Route by predicted capability, verify by evidence, escalate by necessity.
Yani önce görevin ihtiyaç duyduğu kapasiteyi tahmin et, sonucu gerçek mühendislik kanıtlarıyla doğrula ve ancak gerektiğinde daha güçlü kaynağa geç.
Taksim’in kapalı döngüsü
Taksim önce görevi ve bağlamı anlamaya, ardından gereken yetenek ve risk seviyesine göre uygun intelligence resource’u seçmeye çalışıyor. İş yine geliştiricinin mevcut aracı üzerinden yürütülüyor. Sonrasında test, build, lint, source control, CI, tool sonuçları ve insan müdahalesi gibi mühendislik kanıtları gözlemleniyor. Elbette bunlar sabit bir liste değil; proje kendi kalite kontrolünü hangi yöntemlerle yapıyorsa Taksim’in o kanıtları kullanabilmesi gerekiyor.
Sonuç yeterli değilse görev onarılabilir veya daha güçlü bir kaynağa yükseltilebilir. Yeterliyse doğrulanmış sonuç sonraki seçimlerde kullanılabilir. Böylece akış yalnızca “seç ve gönder” ile bitmez; seçim, execution, verification, repair/escalation ve öğrenme birbirine bağlanır.
Buradaki “resource” kelimesi bilinçli. Aynı model farklı runtime’larda, farklı reasoning seviyelerinde veya farklı araç yetenekleriyle aynı kaynak değil. Taksim’in model, provider, runtime, developer client ve execution configuration kavramlarını birbirine karıştırmaması gerekiyor.
Bu nedenle ekonomik hedef de “en ucuz token” değil:
Başarıyla tamamlanmış mühendislik sonucu başına beklenen maliyet.
Ucuz başlayıp üç kez tekrar edilen bir iş, ilk seferde pahalı görünen ama doğru tamamlanan işten daha ekonomik olmayabilir.
Sokaktan geçen spor arabalar
Taksim’e başladığımda bildiğim tek benzer yaklaşım Copilot Auto’ydu. Araştırdıkça önce Not Diamond’ı, ardından isim benzerliğiyle ayrıca dikkatimi çeken Edgee.ai’ı gördüm. Daha sonra Uber’in kendi iç AI altyapısında aynı maliyet ve kalite problemine nasıl yaklaştığını okudum. Projenin MVP’sine en çok yaklaştığım günlerden birinde de GitHub, HydraFusion’ı duyurdu.
Hiçbiri benim için demotivasyon kaynağı olmadı. Aksine, evde çözmeye çalıştığım problemin yalnızca benim çalışma biçimimden doğmadığını; bireysel geliştiricilerden teknoloji devlerine kadar büyüyen ortak bir ihtiyaç olduğunu gösterdi.
Copilot Auto
Copilot Auto, Taksim’e başlarken bildiğim en yakın fikirlerden biriydi. Kullanıcı adına model seçimini platformun yapması, model seçmenin zamanla ürünlerin içine gömülü sıradan bir özellik haline gelebileceğini gösteriyordu.
Her iterasyonda kendime aynı soruyu sordum: Copilot bugün Auto sunuyor; yarın Claude da benzer bir özellik getirirse Taksim’in bütün anlamı ortadan kalkar mı?
Cevabın “evet” olmaması gerekiyordu. Bu nedenle Taksim’i yalnızca model seçen bir katman olarak bırakmadım. Verification, engineering evidence, escalation, şirket politikası, kapasite yönetimi ve sonuçlardan öğrenme gibi platformların kendi Auto özelliklerinin yerine geçemeyeceği parçaları merkeze aldım.
Platform-native Auto özellikleri yaygınlaşırsa Taksim atıl kalmamalı; aksine bu seçimleri şirket politikası ve gerçek mühendislik sonuçları doğrultusunda kullanan üst kontrol katmanı olmalı.
Not Diamond
Not Diamond kendisini coding agent’lar için bir intelligent model router olarak konumluyor. Temel vaadi, her input için uygun modeli tahmin ederek frontier kaliteyi daha düşük maliyetle sunmak. Ağustos 2026’da duyurduğu Not Diamond Code yaklaşımı, agent akışındaki her adım için gelecekteki reward ve maliyeti tahmin etmeyi; cache durumunu ve uzun görev dizilerini de hesaba katmayı hedefliyor.
Bu, Taksim’e en yakın problem alanlarından biri. Ayrım ise kontrol döngüsünde ortaya çıkıyor. Taksim yalnızca çalıştırmadan önce bir model önermek istemiyor; gerçek execution’ı, sonrasında oluşan mühendislik kanıtını, escalation kararını, ekip politikasını ve doğrulanmış outcome’u aynı sistem içinde ilişkilendirmeyi hedefliyor.
Edgee.ai
Ne kadar da benim bir projem gibi görünüyor, değil mi? :) Ama değil; Edgee.ai, EdgeeTech tarafından yapılmadı.
Edgee.ai kendisini bir Agent Gateway olarak tanımlıyor: Agent isteklerini araya girerek gözlemliyor, yönlendiriyor, token’ları sıkıştırıyor, maliyeti ölçüyor ve güvenlik/politika katmanı sağlıyor. “Mevcut agent akışını değiştirmeden kontrol kazanma” yaklaşımı Taksim’le güçlü biçimde örtüşüyor.
Edgee’nin ağırlık merkezi bugün gateway, token ekonomisi, bütçe odaklı routing ve merkezi görünürlük. Taksim’in ayırıcı iddiası ise bir görevin yalnızca ucuz çalıştırılması değil; sonucunun kanıtla doğrulanması ve bu kanıtın gelecekteki routing kararlarına güvenli biçimde bağlanması.
Aynı problem büyük ölçekte nasıl görünüyor? Uber örneği
Bu problem yalnızca routing ürünü geliştiren şirketlerin gündeminde değil. Uber’in Ağustos 2026’da yayımladığı Software Factory çalışması, agent kullanımı büyüdükçe maliyetin yalnızca daha ucuz bir model seçerek yönetilemediğini gösteriyor. Uber; model-task eşleştirmesini, benchmark’ları, session başına maliyeti, canlı harcama göstergelerini ve onay mekanizmalarını birlikte ele alıyor. Kendi verilerine göre, model sabit tutulduğunda bin istek başına maliyet zirve noktasından yaklaşık yüzde 34, session başına maliyet ise yüzde 52 düşmüş. Dynamic model routing de üzerinde çalıştıkları sıradaki adımlardan biri.
Benim için burada önemli olan oranlardan çok yöntem. Uber de modeli ismine veya genel benchmark sırasına göre değil, gerçek iş yükündeki sonuçlarına göre değerlendirmeye çalışıyor. uReview sisteminde Claude 4 Sonnet’i yorum üretmek, o4-mini-high’ı ise üretilen yorumları değerlendirmek için kullanmaları bunun iyi bir örneği. Yani mesele yalnızca en iyi modeli bulmak değil; farklı modelleri doğru aşamalarda kullanmak ve ortaya çıkan sonucu ayrıca doğrulamak.
Uber doğrudan bir Taksim rakibi değil. Fakat aynı problemin büyük bir mühendislik organizasyonunda nasıl görünür hale geldiğini göstermesi bakımından önemli.
HydraFusion ve HyDRA
Projenin MVP’sine en yaklaştığım gün GitHub, Project HydraFusion projesini duyurdu. HydraFusion; yerel, bulut ve compound modeller arasında otomatik semantic routing yapmayı, bunu da geliştirici için seçilebilir tek bir model gibi göstermeyi hedefliyor.
Arkasındaki HyDRA araştırması, bir isteğin reasoning, code generation, debugging ve tool use gibi farklı yetenek ihtiyaçlarını ayrı ayrı tahmin ediyor. Ardından bu ihtiyacı karşılayan en düşük maliyetli modeli seçiyor. Bu yaklaşım, “her işe en güçlü model” varsayımının Microsoft ve GitHub ölçeğinde de sorgulandığını gösteriyor.
HydraFusion ile Taksim arasındaki benzerlik gerçek: İkisi de geliştiricinin araç seçme yükünü azaltmak, özel/yerel ve bulut kaynaklarını birlikte kullanmak ve kalite-maliyet dengesini görev bazında kurmak istiyor.
Fakat bugün gördüğüm temel ayrım şu: HydraFusion’ın kamuya açıklanan odağı multi-model orchestration ve seçim. Taksim’in uzun vadeli odağı ise seçimden sonraki yaşam döngüsü: canonical execution kaydı, engineering evidence, güvenli attribution, verification, repair/escalation, kapasite ve maliyet yönetişimi, ardından outcome learning.
Bu yüzden her yeni özellikte kendime şu soruyu soruyorum:
Bu, Not Diamond veya HydraFusion tarzı routing’in başka bir versiyonu mu; yoksa Taksim’in kendine ait kapalı döngü execution control plane’ine gerçekten katkıda bulunuyor mu?
Gizlilik ve erişilebilirlik sonradan eklenen özellikler değil
Taksim geliştirici trafiğinin ortasında yer alacaksa iki konuda taviz veremez.
Birincisi gizlilik. İstekten yapısal sinyaller çıkarabilmek, ham prompt’u veya kaynak kodunu kalıcı olarak saklamayı gerektirmemeli. Projede kullandığım ilke şu:
Prompt-aware olmak, prompt-owning olmayı gerektirmez.
Burası diğer ürünlerden ayrışmak istediğim en net noktalardan biri. Solo developer olarak bile kendi prompt’umu ve kodumu zorunlu olarak başka bir şirketin gateway’i üzerinden geçirmek istemiyorum. Bir enterprise neden bütün mühendislik içeriğini böyle bir güven sınırının dışına çıkarmak zorunda kalsın?
Rakipler Zero Data Retention veya benzeri güvenlik seçenekleri sunabilir. Taksim’in yaklaşımı ise daha temel: Ham mühendislik içeriği mümkün olduğunca müşterinin ortamından hiç çıkmamalı. Yerel Connector içeriği geçici olarak inceleyip routing için gerekli yapısal sinyalleri çıkarabilir; uzaktaki Intelligence katmanına yalnızca gizlilik açısından güvenli metadata gönderilmelidir. Kalıcı tarafta ise zaman, model/runtime kimliği, token kullanımı, durum ve kanıt seviyesi gibi yapısal veriler tercih edilmelidir.
İkincisi erişilebilirlik. Kontrol katmanı çöktüğünde geliştiricinin AI aracını da kullanamaz hale gelmesi kabul edilemez.
Inference path is sacred. Observability may degrade; availability must not.
Taksim’in gözlem, veritabanı veya intelligence bileşenleri hata verdiğinde inference akışı devam edebilmeli. Bir başka deyişle veri kaybetmeyi göze alabiliriz; geliştiricinin işini durdurmayı değil.
Eylül 2026 itibarıyla proje nerede?
Taksim bugün yalnızca bir sunum veya mimari diyagram değil. .NET tabanlı çalışan bir control-plane çekirdeği, yerel SQLite veri katmanı, CLI, yerel dashboard ve farklı geliştirici araçlarını bağlayan platform-agnostic adapter mimarisi var.
Claude ve Devin geçmiş oturumları ham içerik saklanmadan yapısal olarak keşfedilip içe aktarılabiliyor. Client, runtime, provider, model ve configuration kimlikleri birbirinden ayrı tutuluyor. Gerçekte kullanılan resource ile Taksim’in önerdiği resource’un aynı şey olmadığı sistemin temel kabullerinden biri.
Claude tarafında managed routing artık yalnızca shadow recommendation üretmiyor; gerçek model seçimini uygulayabiliyor. Sonnet 5 managed istekler için varsayılan model, Opus 5 ise verification, repair, risk ve policy sinyalleri gerektiğinde devreye giren escalation katmanı. Kullanıcının izin verilen açık model seçimi korunuyor. Her routing kararı, karşılık gelen gerçek inference execution ile kesin bir kimlik üzerinden ilişkilendirilebiliyor; böylece aynı kullanıcı isteği içinde birden fazla model çağrısı olduğunda bile kanıtlar yanlış kaynağa yazılmıyor.
Codex tarafında da taksim codex, OpenAI Responses trafiğini yerel Connector üzerinden geçirebiliyor. Codex’in kalıcı config.toml, CODEX_HOME, argüman ve authentication akışına dokunulmuyor. Responses JSON/SSE akışından model, durum, token ve execution bilgileri gözlemlenirken ham prompt, model yanıtı veya tool içeriği kalıcı olarak saklanmıyor. İlk sürümde Codex’in model seçimi yeniden yazılmıyor; amaç önce trafiği güvenli ve doğru biçimde control plane’e bağlamak.
Bu iki yolun ortak bir ilkesi var: Taksim çalışamazsa native client kendi normal akışıyla devam ediyor. Kullanıcının karşısına veritabanı hataları veya uzun stack trace’ler dökmek yerine kısa bir bilgi verilip işin sürmesi hedefleniyor.
Mimari de artık üç belirgin sorumluluğa ayrılıyor. Taksim CLI, launcher ve kullanıcı deneyimi katmanı. Geliştirici makinesindeki Connector, yerel interception, privacy-safe metadata çıkarımı, yerel karar ve telemetry’den sorumlu. Taksim Intelligence ise zaman içinde kaynak bilgisi, politika ve doğrulanmış sonuçlardan beslenen uzaktaki karar katmanı olacak. Yerel Connector her zaman kullanılabilir bir karar üretirken remote Intelligence yalnızca sıkı bir latency bütçesi içinde bu kararı iyileştirebilecek; inference için zorunlu bir bağımlılığa dönüşmeyecek.
Taksim henüz geçmiş sonuçlardan kendi routing politikasını öğrenen nihai control plane değil. Bugünkü sistem çalışan ve gerçek model seçimini uygulayan managed bir policy’ye sahip. Learned/adaptive routing ise yeterli ve güvenilir execution evidence oluştuğunda devreye girecek.
Şimdiki hedef yeni özellikler eklemekten çok daha basit: Bir geliştiricinin taksim claude ve taksim codex komutlarını bir hafta boyunca günlük işinde, Taksim işini kesintiye uğratmadan kullanabilmesi; hangi modelin seçildiğini ve ne zaman escalation gerçekleştiğini açıkça görebilmesi; bu sırada sistemin gerçekten işe yarayan canonical evidence toplayabilmesi.
Bundan sonra
İlk gerçek kullanım döneminde ölçmek istediğim şey yalnızca token tasarrufu değil:
- Hangi görevler daha küçük veya özel kaynaklarda güvenle tamamlanabiliyor?
- Hangi sinyaller görevin başında gerçekten öngörücü?
- Hangi verification kanıtları başarıyı güvenilir biçimde temsil ediyor?
- Yanlış düşük model seçiminin tekrar ve düzeltme maliyeti ne?
- Ne zaman escalation yapmak kaliteyi korurken toplam maliyeti düşürüyor?
- Geliştiricinin mevcut akışına ne kadar az müdahale edebiliyoruz?
Bu veriler oluşmadan “yüzde şu kadar tasarruf” gibi bir pazarlama cümlesi kurmak istemiyorum. Taksim’in iddiası bir benchmark tablosundan değil, doğrulanmış mühendislik sonuçlarından çıkmalı.
Son söz
Taksim’e başlarken çözmeye çalıştığım problem cloud AI faturasını azaltmaktı. Bugün hâlâ bu problemin içindeyiz, fakat artık maliyetin tek başına yanlış hedef olduğunu düşünüyorum.
Asıl hedef, bir ekibin sahip olduğu bütün zekâ kaynaklarını — yerel modelleri, özel altyapıyı ve frontier bulut modellerini — işin gerektirdiği kaliteden vazgeçmeden birlikte kullanabilmesi.
Geliştiricinin aracı değişmemeli. Gerekli kalite düşmemeli. Bulut ortadan kalkmamalı; gerektiğinde devreye giren güçlü bir katman olarak kalmalı. Ve sistem, verdiği kararların doğru olup olmadığını gerçek sonuçlardan öğrenebilmeli.
Taksim’in çözmeye çalıştığı problem artık “hangi model daha ucuz?” değil:
Doğru işi, doğru zekâ kaynağına, doğru zamanda nasıl veririz — ve doğru yaptığımızı nasıl kanıtlarız?
Sokaktan geçen spor arabalar bu soruyu geçersiz kılmadı. Tam tersine, yolun gerçekten bir yere çıktığını gösterdi.
Taksim hakkında daha fazlası
Taksim hakkında daha fazla bilgi için taksim.edgee.tech adresini ziyaret edebilirsiniz. Teknik yaklaşımını konuşmak veya kullanım senaryonuzu paylaşmak isterseniz bana LinkedIn ya da e-posta üzerinden ulaşabilirsiniz.
Taksim’i, EdgeeTech Ltd bünyesinde geliştiriyorum.